
Может ли одна внешняя публикация повлиять на то, как часто бренд появляется в ответах ChatGPT, Алисы и других нейросетей? Александр Шерстов, основатель платформы GeoAist.ru и преподаватель ВШЭ, разбирает это на практике: как провести эксперимент, зафиксировать AI-видимость до публикаций и понять, какие изменения действительно можно связать с внешними размещениями.
После выхода статьи на отраслевой площадке рука сама тянется проверить ChatGPT или Алису. Бренд появился в ответе — хочется записать размещение в удачные. Через два дня тот же запрос может дать другой набор компаний, и прежний вывод уже выглядит слишком поспешным.
Один контрольный запрос объясняет слишком мало. Модели меняют состав рекомендаций, новые страницы доходят до поисковых и AI-систем с разной скоростью, а параллельно у компании могут выходить другие материалы, обновляться сайт или карточки в каталогах. Поэтому эксперименту нужна одинаковая выборка запросов и несколько точек замера.
Задача этого теста довольно приземленная: посмотреть, меняется ли присутствие бренда после серии внешних публикаций и держится ли это изменение хотя бы несколько проверок подряд. Разовый всплеск просто сохраняем в истории и ждем следующих замеров.
Что именно проверяем
Берем рабочую гипотезу: на тематических площадках выходят новые статьи, где корректно указаны название компании, услуга, регион и сайт. После индексации этих страниц бренд может чаще появляться по связанным коммерческим запросам. Для нас интересен сценарий, когда рост повторяется в нескольких моделях и сохраняется хотя бы в двух-трех следующих замерах.
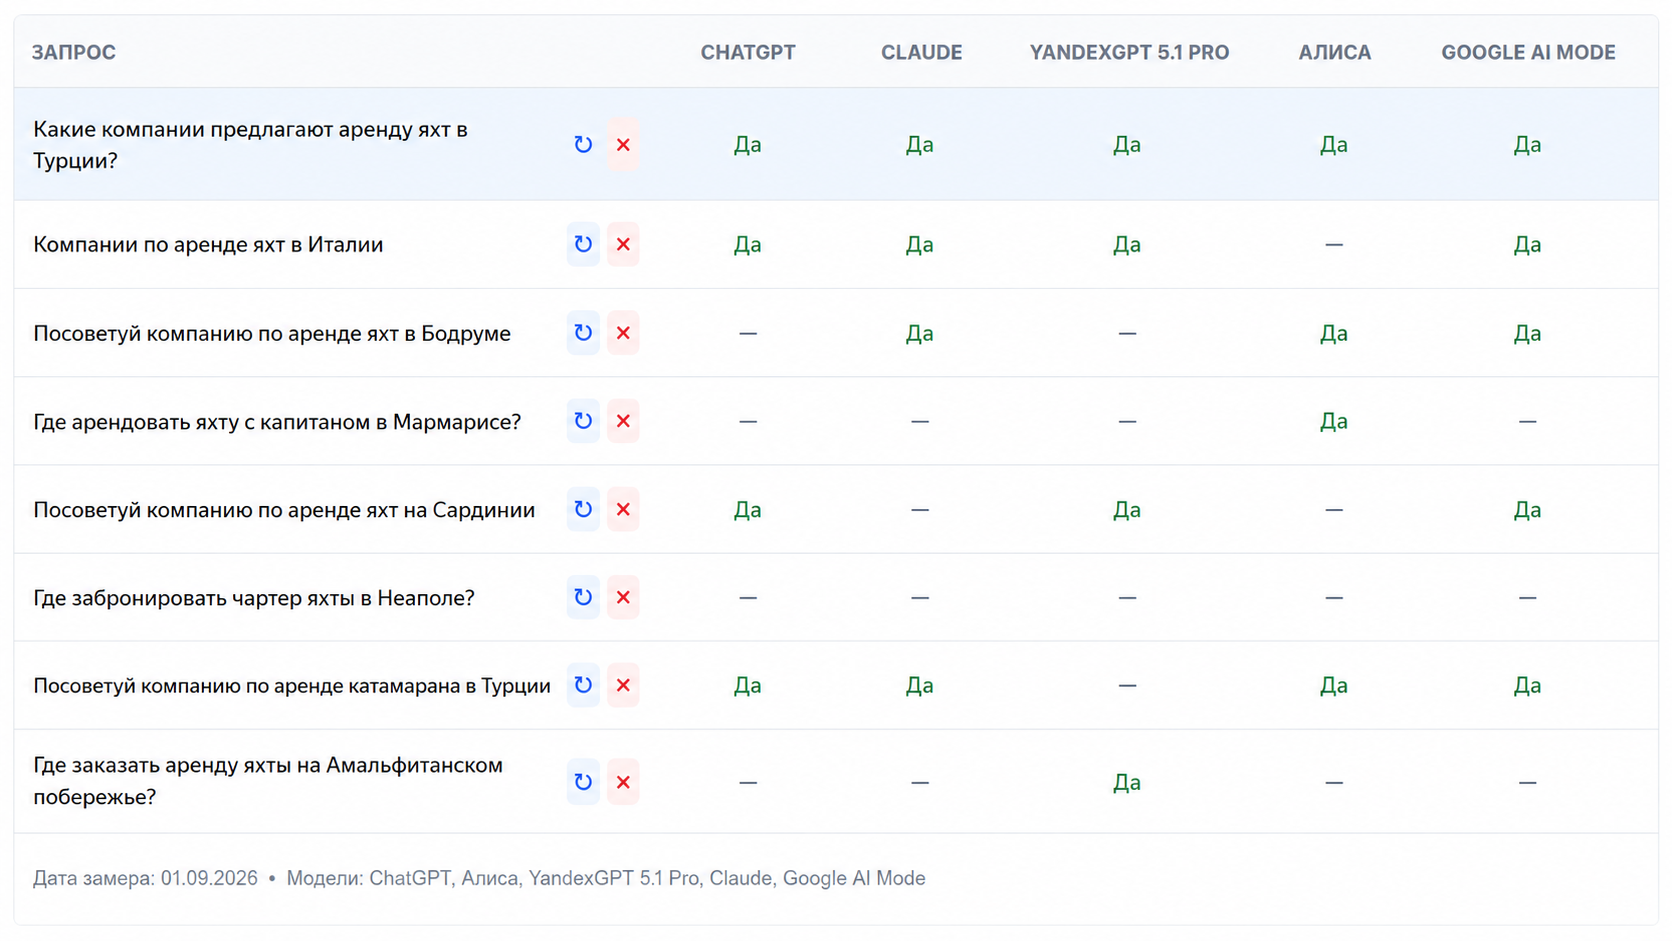
Допустим, компания занимается арендой яхт. В выборку можно включить запросы «Какие компании предлагают аренду яхт в Турции», «Где забронировать чартер яхты в Неаполе» и «Посоветуй компанию по аренде яхт в Бодруме». Запросы с названием самой компании лучше вынести в отдельный список: там модель уже получает подсказку, о каком бренде говорить.
Для первого прогона хватит 30–50 коммерческих промптов. Примерно две трети можно связать с темами будущих публикаций, оставшуюся часть оставить контрольной — в той же нише, но с другими услугами или формулировками. Если движение появится в целевой группе, а контроль почти останется на прежнем уровне, у нас появится нормальный повод разбирать влияние размещений дальше.
Сначала фиксируем точку отсчета
Исходный замер делаем до выхода статей. Каждый промпт проверяем в одном наборе моделей — например, ChatGPT, Алисе, YandexGPT, Claude и Google AI Mode — и повторяем прогон в разные дни. Так видно, какие запросы уже дают стабильное присутствие, а где бренд появляется случайно.
По каждому запросу достаточно сохранить четыре вещи: есть ли компания в ответе, на какой позиции она стоит в подборке, какие источники указала модель и кто из конкурентов оказался рядом. Через несколько повторов картина становится заметно полезнее одиночного скрина: один запрос может держать бренд почти всегда, другой — давать его один раз из четырех.
Публикации тоже нужно зафиксировать как часть эксперимента
Следующий шаг — сами размещения. Тексты лучше развести по смыслу: на одной площадке выходит кейс, на другой разбор проблемы, на третьей инструкция или исследование. При этом базовые сведения о компании должны совпадать везде: написание бренда, сайт, услуги, география, специализация.
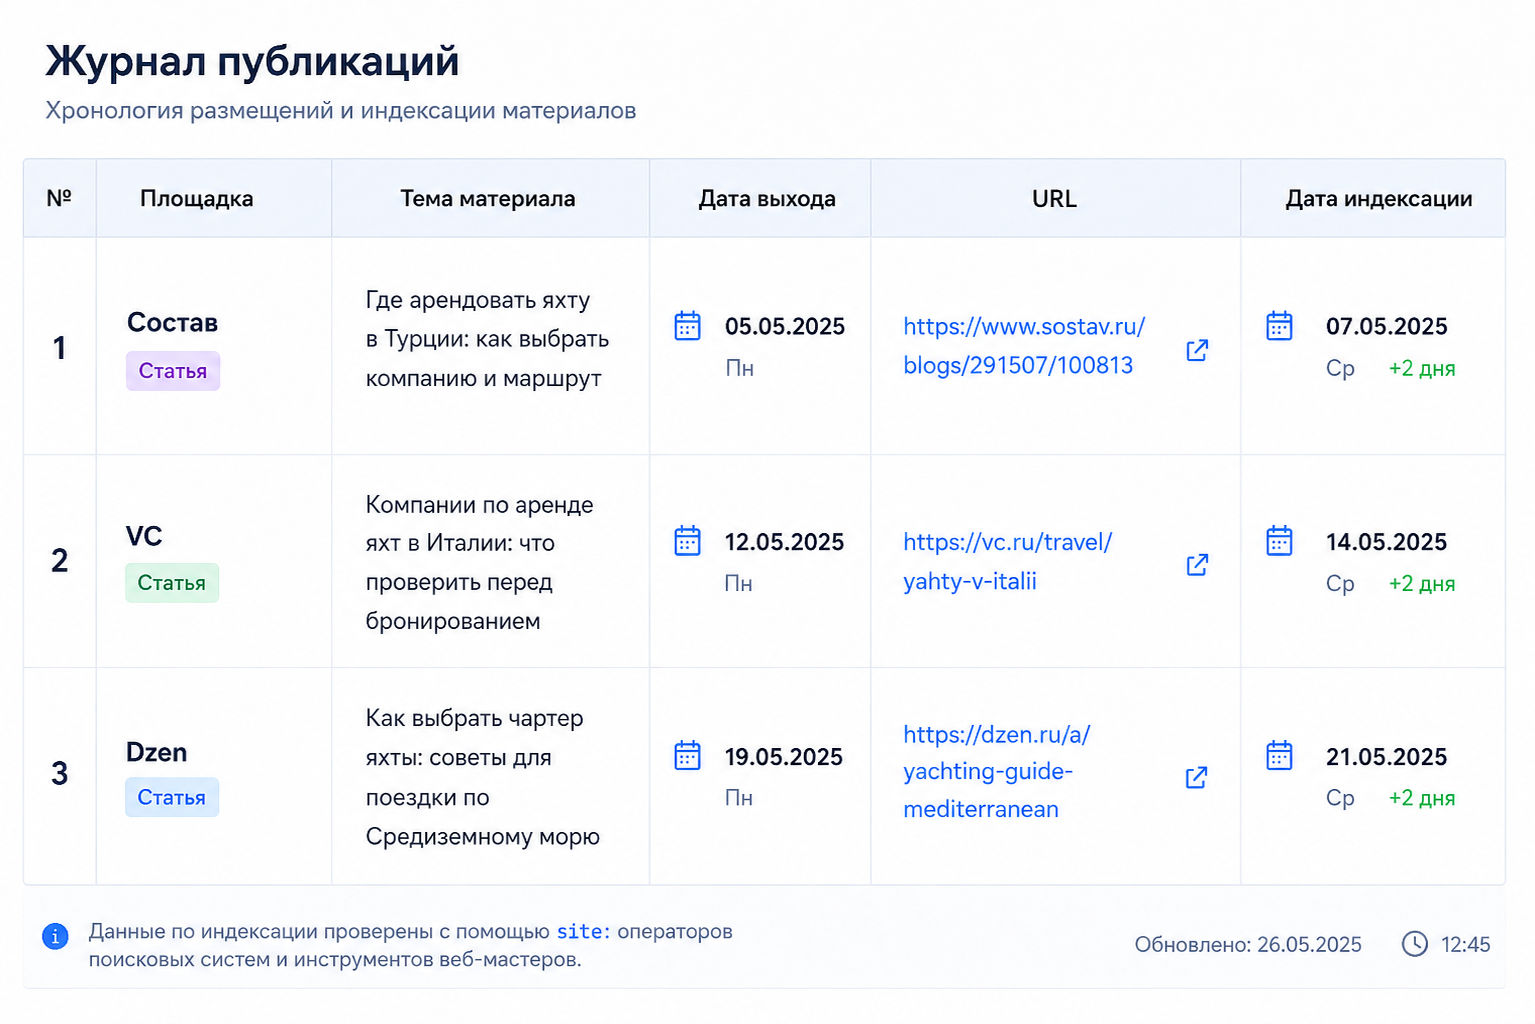
Для пилота удобно взять 3–5 площадок и выпустить материалы за одну-две недели. В рабочей таблице сохраняем URL, дату выхода, тему и дату, когда страница появилась в поиске. На время теста крупную переделку сайта и массовый PR лучше отложить: иначе через месяц станет трудно понять, что именно совпало по времени с ростом AI-видимости.
Когда делать повторные проверки
Проверка на следующий день годится скорее для контроля индексации и явных сдвигов. Основные точки лучше назначить заранее: например, через 3, 7, 14 и 30 дней после появления публикации в поиске. Набор промптов и моделей на протяжении теста остается прежним.
Представим обычную картину: на третий день все стоит на месте, через неделю бренд появляется по пяти целевым запросам в двух моделях, а к концу месяца держится уже в десяти. Такой график дает материал для разговора. Пара случайных ответов в разные дни дает слишком мало оснований для вывода.
Какие метрики считать
Количество упоминаний удобно, но одной этой цифры мало. Если бренд встретился 20 раз за месяц, хочется знать, по скольким разным запросам это произошло, в каких моделях и сколько раз результат повторился. Поэтому в отчете лучше держать рядом несколько показателей.
|
Метрика |
Что показывает |
|
Доля промптов с брендом |
Процент коммерческих запросов, где компания появилась хотя бы в одной модели. |
|
Покрытие по моделям |
Сколько нейросетей называют бренд по одному и тому же запросу. |
|
Стабильность |
В какой доле повторных проверок компания сохраняется в ответе. |
|
Доля цитирований |
Как часто рядом с упоминанием появляется ссылка или источник, связанный с компанией. |
|
Доля относительно конкурентов |
Как часто бренд встречается в выборке по сравнению с основными конкурентами. |
Историю ответов можно собирать вручную или через мониторинг AI-выдачи; в нашем тесте для этого используется GeoAist. Его роль здесь техническая: сохранить одинаковые проверки по датам, промптам и моделям, чтобы потом сравнить периоды.
Как читать результат аккуратно
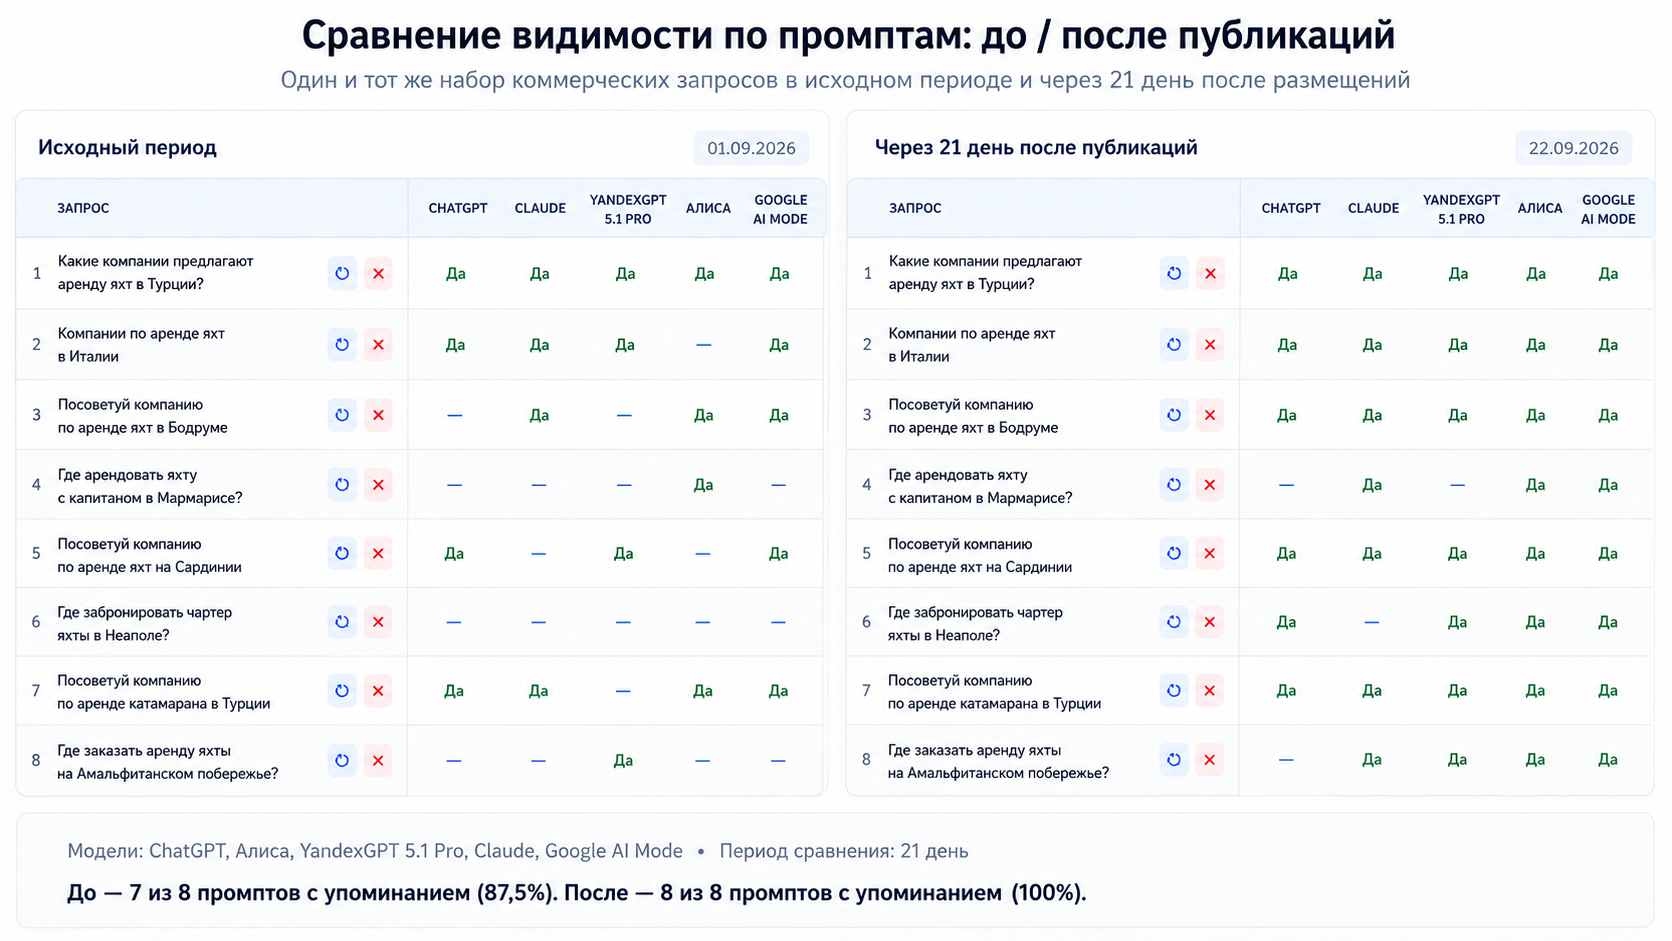
Самый убедительный сценарий выглядит так: до размещений бренд встречался редко, после публикаций доля целевых промптов с упоминанием выросла, а рост повторился в нескольких моделях. Еще один хороший сигнал — одна из новых статей начала появляться среди источников ответа. В такой ситуации уже есть цепочка событий, которую можно показать читателю вместе с датами.
Слабее выглядит история, где компания появилась один раз в одной модели и пропала на следующей проверке. Такой эпизод лучше оставить в журнале наблюдений и дождаться повторов. Если через неделю результат вернется по тем же запросам, у него появится вес; если исчезнет, это останется обычным колебанием генерации.
Контрольная группа помогает поймать еще один сценарий. Допустим, целевые запросы выросли на 20%, и примерно так же прибавила контрольная выборка, с которой публикации напрямую связаны слабо. Тогда причина, скорее всего, шире одной серии статей: мог обновиться сайт, появиться крупный внешний источник или поменяться сама выдача модели.
Где эксперимент чаще всего ломается
Самый частый способ испортить сравнение — менять запросы по ходу теста. В начале было 20 общих формулировок, после публикаций в таблицу добавили еще 30 удобных — и цифры уже сравнивают разные выборки. Основной список лучше зафиксировать заранее, а новые идеи собрать для следующего прогона.
Брендовые вопросы тоже искажают картину. Запрос «Что известно о компании N» почти всегда дает высокий шанс на упоминание, потому что название уже присутствует в формулировке. Для оценки реальной конкуренции полезнее вопросы «кого выбрать», «где заказать», «какие компании делают…»: здесь модель сама формирует список.
Еще одна проблема возникает, когда за тот же месяц меняется весь проект. Компания может переписать сайт, получить десятки отзывов, выпустить пять статей и попасть в отраслевой рейтинг. Для бизнеса такой рывок полезен, а вклад отдельного размещения после него посчитать уже трудно.
Как выглядит минимальный эксперимент на практике
Рабочий пилот помещается примерно в месяц. Сначала собираем 30–50 коммерческих промптов и делаем несколько исходных проверок, затем выпускаем 3–5 уникальных материалов на тематических площадках. После индексации возвращаемся к тем же запросам по заранее выбранным датам.
В конце сравниваем целевую и контрольную группы, отдельные модели и повторяемость упоминаний. Если бренд вырос с [вставить исходное значение] до [вставить итоговое значение] по целевым запросам, а контроль изменился заметно слабее, это уже можно разбирать как кейс. В публикации лучше показать исходные скрины и даты — тогда читатель сам увидит, откуда взялся вывод.
Что можно вынести из такого теста
У внешней публикации есть конкретная дата, тема и набор запросов, с которыми она связана по смыслу. Если рядом лежит история AI-видимости за тот же период, разговор становится предметным: видно, где бренд прибавил, в каких моделях и насколько долго результат продержался. Это намного полезнее ощущения «кажется, нас стали чаще советовать».
Нулевой результат тоже пригодится. Например, статья проиндексировалась, месяц прошел, а целевая группа осталась примерно на прежнем уровне. Тогда следующую итерацию можно менять осмысленно: выбрать другую площадку, другой тематический кластер или проверить, достаточно ли подробно бренд описан в самом материале.
FAQ
1. Сколько публикаций нужно для первого теста?
Для пилота обычно достаточно 3–5 размещений на тематически близких площадках. Такой объем еще можно сопоставить по датам и темам, а пакет из нескольких десятков публикаций уже сильно усложняет разбор причин.
2. Через сколько дней смотреть результат?
Я бы закладывал несколько контрольных точек — 3, 7, 14 и 30 дней после индексации. Если движение появляется только на одной дате, продолжаем наблюдение; если оно повторяется, сигнал становится интереснее.
4. Хватит ли среза по одной ИИ-модели?
Для нормального среза лучше взять несколько моделей, потому что их шорт-листы заметно расходятся. Бренд может регулярно появляться в Алисе и YandexGPT и почти отсутствовать в другой системе, поэтому одна модель дает слишком узкую картину.
5. Что считать хорошим результатом?
Я бы смотрел на три вещи вместе: выросла доля коммерческих запросов с брендом, рост повторился в нескольких проверках и появился хотя бы в двух моделях. Если новая публикация еще и попала в источники ответа, связь с размещением выглядит заметно убедительнее.