
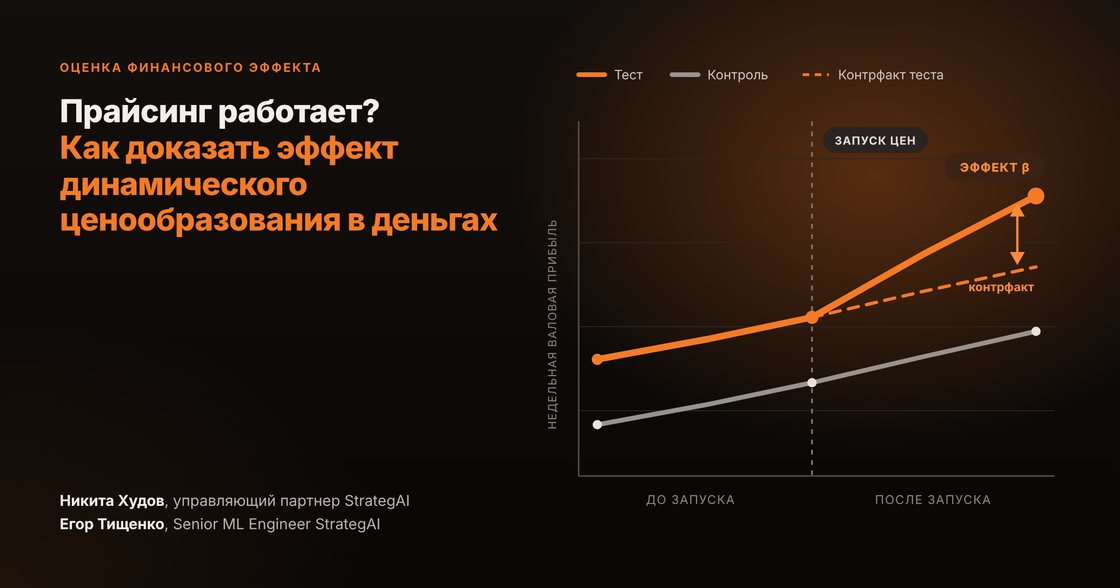
Даже если прибыль после запуска новых цен выросла, это еще не доказывает, что ее принесли именно новые цены. Рост смешивает эффект алгоритма с сезонностью, промо и спросом. Как на реальном пилоте в крупном ритейле выбрали бизнес-метрику, построили эксперимент и оценили финансовый эффект так, чтобы результат можно было защитить перед финансовым директором, рассказывают управляющий партнер StrategAI Никита Худов и Senior ML Engineer Егор Тищенко.
Каждую неделю система динамического ценообразования заново искала баланс цены и спроса
Для крупного ритейлера мы разработали систему динамического ценообразования, которая по истории продаж, цен, скидок и сезонности оценивала, как спрос отреагирует на разные варианты цены. Мы не раскрываем клиента и нормируем цифры, но сохраняем логику проекта, эксперимента и принятия решения.
Раз в неделю алгоритм формировал новые цены: не просто повышал или снижал их, а искал вариант с наибольшей ожидаемой валовой прибылью. При этом он учитывал реакцию спроса и бизнес-ограничения: высокая цена бесполезна, если из-за нее покупатели перестают покупать.
Пилот проходил на выбранных товарных сериях и регионах. Часть единиц получала еженедельные цены алгоритма, сопоставимая часть продолжала работать по прежней ценовой политике. По итогам бизнесу предстояло решить, стоит ли масштабировать новую ценовую политику на больший ассортимент и географию, доработать ее или остановить. Для этого было мало показать, что система умеет менять цены: нужно было оценить дополнительную валовую прибыль и сопоставить ее со стоимостью разработки, внедрения и эксплуатации.
Главный вопрос — какую часть финансового результата создали именно новые цены, а не сезонность, промо или изменение спроса. Но сначала нужно договориться, что именно считать финансовым эффектом.
У прайсинга нет одной правильной метрики
Цена воздействует на бизнес через два рычага. Чем она выше, тем больше компания зарабатывает на одной продаже — но тем меньше покупателей могут согласиться на покупку. Поэтому универсальной метрики успеха для прайсинга нет: если приоритет — рост оборота или ускорение продаж, основной метрикой может быть выручка или GMV; если задача — финансовый результат, логичнее смотреть на валовую или маржинальную прибыль.
Ключевой принцип другой: primary metric выбирают до эксперимента и связывают с конкретной целью пилота. Иначе после запуска легко найти показатель, по которому результат выглядит выигрышно. Нормированный пример показывает эту ловушку: цена снизилась на 10% (со 100 до 90 ₽), продажи выросли на 15%, выручка — на 3,5%, а валовая прибыль упала на 13,8% (с 4 000 до 3 450 ₽). Выручка при этом не «неправильная» метрика — она уместна для другой бизнес-цели. Проблема возникает, когда критерий успеха выбирают уже после того, как увидели результат.
Цель пилота — понять, приносит ли новая ценовая политика бизнесу дополнительную прибыль. Поэтому главным показателем выбрали недельную валовую прибыль. В упрощенном виде это сумма маржи всех заказов экспериментальной единицы за неделю: Σ (цена продажи − себестоимость) × количество. Метрика объединяет оба эффекта новой цены — изменение дохода с одной единицы и реакцию спроса — и переводит результат в рубли, которые можно связать с P&L.
Продажи и выручку отслеживают как guardrail-метрики — защитные ограничения. Например, до запуска можно зафиксировать правило: масштабировать новую ценовую политику только в том случае, если валовая прибыль выросла, а количество проданных товаров снизилось не более чем на 5%.
Расчет ведется по каждой единице эксперимента за неделю, одинаково для теста и контроля, включая недели с нулевыми продажами: новая цена сама влияет на то, какие товары будут куплены и сколько покупок состоится.
+12% после запуска — еще не эффект прайсинга
Самый простой способ оценить пилот — сравнить среднюю прибыль до и после запуска. Допустим, до пилота тестовый ассортимент приносил в среднем 100 условных единиц валовой прибыли в неделю, а после запуска — 112. Но +12% — это наблюдаемое изменение теста, а не доказанный эффект новой цены: за эти недели изменилась не только ценовая политика.

Один и тот же рост теста на 12% дает разный эффект в зависимости от динамики контроля
Если сопоставимые товары без нового прайсинга выросли на 9%, на долю ценовой политики остается около 3 п.п. Если же они выросли на 16%, те же «+12% после запуска» означают отрицательный результат относительно контрфакта.
За время пилота меняются сезонность, реклама, промо, наличие и товарный микс. Даже длинный период «до» не решает проблему: он показывает историю, но не отвечает на вопрос, что произошло бы с тестовыми товарами именно в недели пилота. Для этого нужна контрольная группа, которая живет в то же календарное время и сталкивается с теми же внешними изменениями, но продолжает работать по старой ценовой политике.
«До и после» показывает, как изменился бизнес. Эксперимент должен показать, какая часть этого изменения появилась благодаря новым ценам.
Что делить на тест и контроль — зависит от задачи
Рандомизировать покупателей можно для персонализированных цен, купонов или промо. В нашем пилоте проверяли общую ценовую политику для ассортимента: цена была свойством товара в конкретном регионе, а один и тот же человек мог зайти с разных устройств и увидеть обе цены.
Единицей рандомизации стала товарная серия × регион: серия похожих товаров в одной географической ценовой зоне. Вся такая единица целиком попадала либо в тест, либо в контроль. Тест и контроль формировали примерно 50/50 внутри каждого региона с учетом масштаба и исходных показателей серий.
Рандомизировать отдельные SKU — товарные позиции с собственным артикулом — нельзя. Если алгоритм снизил цену одной модели пылесоса, покупатели могут переключиться на нее с похожей модели из контроля. Это spillover: изменение в тесте влияет на результат контроля.
Один из главных источников spillover в прайсинге — каннибализация. Если товары-субституты разнесены между test и control, нельзя отделить изменение общей прибыли от перетока продаж между плечами. Оценка может сместиться к нулю, завыситься или даже сменить знак. В статье Science of price experimentation at Amazon в разобранном авторами эксперименте каннибализация снижала продажи в control, поэтому наивная DiD-оценка завышала эффект. В их симуляциях кластерная рандомизация снижала смещение в среднем на 30% относительно наивного подхода, но стандартное отклонение оценки в среднем удваивалось.

Рисунок 2. Каннибализация между тестом и контролем и правильная группировка субститутов
Поэтому субституты ищут до запуска. Пары товаров, между которыми возможно переключение спроса, формируют по характеристикам и экспертной логике, а затем проверяют на истории: по перекрестной ценовой эластичности, по естественным ценовым изменениям после акций и, если доступны данные, по поведению покупателей. Связанные серии объединяют в блок, и весь блок субститутов × регион целиком попадает либо в test, либо в control. Так переток остается внутри одной группы и учитывается в общем финансовом результате.
Альтернативный дизайн — switchback² или crossover, когда кластер попеременно работает то по новой, то по старой политике. В экспериментах Amazon он сокращал стандартные ошибки примерно на 40–50%¹, но для товаров с длинным циклом выбора создает риск carryover: покупатель может увидеть цену и вернуться уже после переключения политики. Поэтому для пилота выбрали time-bound дизайн: кластер сохраняет одну политику на всем протяжении эксперимента.
Хорошая единица рандомизации — это граница, через которую эффект новой цены не перетекает из теста в контроль.
До запуска нужно зафиксировать не только группы, но и правила сравнения
После формирования кластеров тест и контроль балансируют стратификацией по прошлой прибыли, размеру кластера и региону. Это снижает риск, что в тест случайно попадет заметно больше крупных или быстро растущих серий.
Есть нетривиальный момент: товарная серия во время пилота не обязана оставаться неизменной. Одни SKU могут появиться в ассортименте, другие — выбыть, попасть в распродажу или получить уценку. Если в контрольной серии появились новые популярные товары, а в тестовой — нет, анализ может ошибочно приписать разницу прайсингу. Поэтому до запуска фиксируют и правила работы с изменениями состава серий: как учитывать новые, выбывшие и уцененные SKU. Эти правила одинаковы для теста и контроля и не меняются после того, как команда увидела результаты. Так соблюдается принцип Like-for-Like: мы сравниваем сопоставимый состав ассортимента, а не смешиваем эффект цены с эффектом появления или исчезновения товаров.
История до запуска помогает точнее оценить эффект
Рандомизация создает честное сравнение теста и контроля, но сама по себе не гарантирует точную оценку: у товарных серий разные исходные уровни прибыли, а недельные показатели шумят из-за колебаний спроса, наличия и промо. Чтобы повысить точность, в анализ добавили восемь недель истории до запуска — достаточно, чтобы увидеть обычные колебания спроса, и достаточно близко к пилоту, чтобы описывать актуальный режим бизнеса, — и использовали Difference-in-Differences (DiD)³. Механика простая: сначала DiD сравнивает каждую группу с ее собственной историей, а затем вычитает изменение контроля из изменения теста. Постоянная разница между крупной и небольшой серией перестает быть эффектом. Общий рост категории, который одновременно произошел в обеих группах, тоже не записывается на счет алгоритма.

Как читать Difference-in-Differences: эффект — разрыв теста и его контрфакта после запуска
Главная предпосылка DiD — параллельные тренды: до запуска тест и контроль могут находиться на разных уровнях, но их динамика должна быть сопоставимой. Если тестовые серии росли быстрее еще до новых цен, метод рискует приписать алгоритму уже существовавший тренд. В рандомизированном пилоте предпосылка выполняется в ожидании за счет дизайна, а проверка пре-трендов — лишь диагностика⁴.
Критичны и асимметричные вмешательства: например, дополнительная рекламная поддержка только тестовой группы, ручное изменение цен в одном из плеч или систематически разный уровень наличия.
DiD не делает плохой эксперимент хорошим. Он помогает точнее использовать тот контрфакт, который уже создает дизайн пилота.
Как оценивали эффект новой ценовой политики
В реальном пилоте товарных кластеров и недель много, поэтому DiD реализован как регрессия на недельной панели, где одна строка — серия товаров в регионе за неделю. В упрощенном виде модель — регрессия с двусторонними фиксированными эффектами (TWFE) — выглядит так:
Yᵢₜ = αᵢ + γₜ + β · (Testᵢ × Afterₜ) + εᵢₜ
Здесь αᵢ учитывает постоянные различия между товарными кластерами, γₜ — события, общие для теста и контроля: сезон, праздники или изменение спроса. β — искомый эффект: сколько дополнительной недельной валовой прибыли в среднем принесла новая ценовая политика одной экспериментальной единице. Стандартные ошибки кластеризуются на уровне единицы рандомизации: десять недель одной товарной серии — это не десять независимых экспериментов.
Перед запуском весь контур измерения проверяют на исторических данных. A/A-тест показывает, не находит ли метод «эффект» там, где его заведомо нет. Power simulation — найдет ли метод эффект, если он действительно появится: в исторические данные добавляют известный uplift и смотрят, как часто модель его обнаруживает. В иллюстративном примере эффект +5% находится лишь в 42% прогонов, а +8% — уже в 80%. Так определяется MDE — минимально обнаружимый эффект, который дизайн находит с мощностью 80% при α = 5%: в этом примере — около +8%.
Если для окупаемости бизнесу достаточно +3%, а эксперимент способен надежно увидеть только +8%, пилот плохо отвечает на бизнес-вопрос. Отрицательный результат такого теста еще не докажет, что экономически полезного эффекта нет.
Хороший эксперимент защищает от двух потерь: вложиться в пустой эффект и закрыть решение, которое могло приносить деньги.
«Эффект есть» и «эффект не найден» — не единственные ответы
После пилота бизнесу хочется получить бинарный вывод: алгоритм работает или нет. Но решение нужно принимать одновременно по размеру эффекта, неопределенности оценки и минимальному эффекту, который имеет смысл для бизнеса. Одинаковый uplift в +6% может означать разные вещи: интервал от +5% до +7% довольно точно локализует эффект, а интервал от −2% до +14% допускает и небольшой отрицательный результат, и существенный рост.

Рисунок 4. Одна шкала — четыре ориентира для решения (иллюстративный пример)
По доверительному интервалу возможны четыре корректных вердикта:
-
интервал целиком выше нуля — есть свидетельства положительного эффекта;
-
интервал целиком ниже нуля — есть свидетельства отрицательного эффекта;
-
интервал пересекает ноль и остается широким — данных недостаточно для вывода;
-
интервал узкий и целиком ниже бизнес-порога — значимого эффекта, вероятно, нет.
Допустим, оценка равна +4%, а доверительный интервал — от −2% до +10%. Нельзя сказать, что эффекта нет: эксперимент просто не дал достаточно точного ответа. Другой случай: оценка +0,5%, интервал от −1% до +2%, а для окупаемости нужен рост минимум на 3%. Здесь можно сделать более полезный вывод: эффект нужного бизнесу размера не подтверждается и, вероятно, отсутствует.
Поэтому до запуска определяют два значения. Бизнес-порог — минимальный uplift, при котором дополнительная прибыль покрывает разработку, инфраструктуру и сопровождение. MDE — минимальный uplift, который дизайн способен надежно обнаружить. Если порог ниже MDE, дизайн нужно усиливать: увеличивать число независимых кластеров, продолжительность или менять сам эксперимент. Возможна и обратная ситуация: эффект статистически подтвержден, но слишком мал, чтобы окупить решение. Поэтому итоговое решение принимается в два шага: статистический — отделили ли мы результат от случайного шума, и экономический — достаточно ли найденного эффекта для масштабирования.
Вердикт принимается по заранее выбранной недельной валовой прибыли. Красивый результат в одном из десятков сегментов почти всегда найдется случайно: если сегмент не был выбран заранее, такой вывод остается гипотезой для следующего теста.
Отсутствие статистической значимости — не доказательство отсутствия эффекта. Полезный вывод появляется тогда, когда точность эксперимента позволяет ответить на бизнес-вопрос.
Модель назначает цену. Эксперимент превращает ее в P&L
У оценки динамического ценообразования есть три главных правила.
Первое — эффект нельзя увидеть напрямую. Рост прибыли после запуска еще ничего не доказывает: нужен контрфакт, который показывает результат бизнеса без новой ценовой политики в те же недели.
Второе — дизайн важнее сложности формулы. Если связанные товары попали в разные группы или тысячи зависимых заказов выданы за независимые наблюдения, продвинутый статистический метод лишь аккуратно посчитает неправильный эффект.
Третье — решение не помещается в один p-value. Нужно одновременно смотреть на размер эффекта, доверительный интервал, MDE и бизнес-порог. Только так можно отличить отсутствие результата от эксперимента, которому просто не хватило мощности.
Чек-лист пилота:
-
Зафиксирована основная метрика. Она соответствует бизнес-цели пилота; в этом случае — недельная валовая прибыль.
-
Определен бизнес-порог. Понятно, какой минимальный uplift окупает разработку, инфраструктуру и сопровождение.
-
Зафиксирован периметр. Товары, географии, каналы, baseline и период пилота не меняются после появления первых результатов.
-
Выбрана единица рандомизации. Связанные товары объединены так, чтобы эффект не перетекал из теста в контроль.
-
Группы сбалансированы до запуска. Использованы подходящие baseline-характеристики и проверено, что одно плечо случайно не получило систематически более сильные кластеры.
-
Корректно выбран и настроен метод оценки. Он соответствует дизайну эксперимента, учитывает структуру данных, а его ключевые предпосылки проверены.
-
Проверена мощность. A/A не создает систематических ложных эффектов, а MDE соответствует бизнес-задаче.
-
Контролируются дополнительные вмешательства. То, что можно заморозить, фиксируется заранее; промо, реклама, ручные изменения цен, out-of-stock и другие события проводятся симметрично либо логируются для анализа.
-
Правило решения задано заранее. Понятно, при каких условиях пилот масштабируется, продлевается или останавливается.
-
После пилота оцениваются эффект и неопределенность. Вывод содержит uplift в рублях и процентах, доверительный интервал, MDE и бизнес-порог.
-
Масштабирование учитывает экономику решения. Результат пилота не переносится на весь бизнес без проверки применимости и расходов.
Динамическое ценообразование создает ценность не тогда, когда алгоритм изменил цену. А тогда, когда честный эксперимент доказал, сколько дополнительных денег эта цена принесла бизнесу.